

11 Std vor
Der erste Docker-Build dauert Minuten, der zweite nur Sekunden – solange niemand die Anweisungsreihenfolge ändert. Dabei entscheidet oft allein die Reihenfolge im Dockerfile, ob der Cache greift oder nicht.
Das kennt jeder, der einmal ein Dockerfile (das Baurezept für ein Container-Image) geschrieben hat. Wer die Reihenfolge nicht versteht, wartet bei jeder kleinen Änderung wieder so lange wie beim ersten Mal.
Der Build-Cache ist ein Speicher für fertige Schichten. Ein Docker-Image besteht aus Schichten: Jede Anweisung wie FROM, RUN oder COPY erzeugt genau eine, die auf der vorherigen aufbaut. Beim Neubau prüft Docker jede Anweisung von oben nach unten und übernimmt unveränderte Schichten unverändert. Sobald sich eine Anweisung ändert, sind alle folgenden Schichten ungültig und werden neu gebaut – auch wenn sie selbst gleich geblieben sind.
Ein typisches Dockerfile für eine Node-Anwendung kopiert zuerst nur package.json, führt npm install aus und kopiert danach erst den Quellcode. Der Cache-Schlüssel einer Anweisung umfasst den Anweisungstext und den Inhalt kopierter Dateien: Ein geändertes package.json macht die Installations-Schicht ungültig, ein geänderter Quelltext nur die Kopier-Schicht. Eine reine Codeänderung baut also nur die letzte Schicht neu.
Verwechselt wird der Cache gern mit einem bloßen Zeitmesser. Er prüft keine Ähnlichkeit, sondern exakte Schlüssel. Steht COPY ganz oben, macht jede kleine Codeänderung die teure Installations-Schicht ungültig – und der Build dauert jedes Mal wie beim ersten Mal. Deshalb gilt: selten Geändertes wie das Basis-Image (das Image, auf dem das eigene aufbaut, etwa in der FROM-Anweisung) an den Anfang, häufig Geändertes wie den Quellcode an das Ende.
Der Build-Cache belohnt keine schönen Dockerfiles, sondern stabile Anweisungsreihen.
📌 Schichten · Cache-Schlüssel · Reihenfolge
📚 Cloud von Grund auf · Tag 5 von 30
#docker #devops #CloudHosting
17 Std vor
Zehn Sekunden Codeänderung, dann wartet man fünf Minuten auf denselben Build. Schuld ist meist eine einzige Zeile an der falschen Stelle im Dockerfile.
Gemeint ist der Aufbau eines Container-Images aus einer Beschreibungsdatei, dem Dockerfile. Das Image ist die unveränderliche Vorlage, aus der Container gestartet werden. Jede Anweisung darin – etwa COPY zum Kopieren von Dateien oder RUN zum Ausführen eines Befehls – erzeugt eine eigene Schicht, und der Build-Cache entscheidet, welche davon neu berechnet werden muss.
Zuerst liest das Build-Werkzeug das Dockerfile von oben nach unten und prüft jede Anweisung gegen den Cache. Sind Anweisungstext und Inhalt kopierter Dateien unverändert, wird die vorhandene Schicht wiederverwendet. Das Ergebnis ist sofort da, ohne Rechenarbeit.
Dann stößt das Werkzeug auf die erste geänderte Anweisung, etwa ein neues COPY mit anderem Quellcode. Diese Schicht wird neu gebaut. Der Cache-Schlüssel umfasst dabei beide Teile: Anweisungstext und Dateiinhalte.
Danach sind alle folgenden Schichten ungültig, auch wenn sie selbst gleich geblieben sind. Steht die teure Installation der Abhängigkeiten unterhalb des Quellcode-Kopierens, muss sie bei jeder Codeänderung erneut laufen – der Build dauert dann wieder so lange wie beim ersten Mal.
Zuletzt dreht man die Reihenfolge um: erst die Abhängigkeitsliste wie package.json kopieren und installieren, danach erst den Quellcode. Eine reine Codeänderung baut dann nur noch die letzte Schicht neu, aus Minuten werden Sekunden. Eine .dockerignore-Datei hält zudem unnötige Dateien aus dem Build-Kontext fern.
Der Cache ist kein Automatik-Glück, sondern folgt der Reihenfolge der Anweisungen. Seltenes nach oben, Häufiges nach unten: Diese eine Sortierung entscheidet über die Dauer jedes Neubaus.
📌 Schichten · Cache-Schlüssel · Reihenfolge
📚 Cloud von Grund auf · Tag 5 von 30
#docker #devops #CloudHosting
1 Tag vor
Viele Einsteiger warten bei jeder kleinen Codeänderung erneut auf die komplette Paketinstallation. Dabei reicht eine andere Reihenfolge der Befehle, damit fast alles aus dem Cache kommt.
Nach dem Ändern einer einzigen Quellcodezeile läuft der komplette Build von vorn. Pakete werden wieder heruntergeladen, obwohl sie schon im vorherigen Build steckten.
Ein Dockerfile ist eine Schritt-für-Schritt-Anleitung, wie ein Image gebaut wird. Jeder Befehl erzeugt eine Schicht, also einen festen Layer im Image. Docker nutzt einen Build-Cache: Eine Schicht wird nur neu gebaut, wenn sich ihr Befehl oder die hineinkopierten Dateien geändert haben. Der Cache wird von oben nach unten geprüft – ab der ersten veränderten Schicht muss alles Folgende neu gebaut werden, auch wenn die Befehle gleich bleiben.
Ein typisches Dockerfile beginnt mit COPY des kompletten Quellcodes und installiert danach erst die Pakete mit RUN apt-get install. Jede noch so kleine Codeänderung trifft die erste Schicht und invalidiert alle folgenden. Die Paketinstallation läuft bei jedem Build erneut. Dreht man die Reihenfolge um – erst Pakete installieren, dann den Code kopieren – bleibt die teure Installation im Cache, wenn nur eine Codezeile geändert wird.
So prüft man es: Beim zweiten Build ohne Änderungen sollte Docker jeden Schritt aus dem Cache beantworten. Nach einer Codezeilen-Änderung dürfen nur die Schichten ab dem COPY neu laufen.
Erst das Seltene, dann das Häufige gehört ins Dockerfile. Häufig Geändertes gehört ans Ende des Dockerfiles, nicht an den Anfang.
📌 Build-Cache · Schichten · Befehlsreihenfolge
📚 Cloud von Grund auf · Tag 5 von 30
#docker #devops #CloudHosting
1 Tag vor
Ein Docker-Image ist die Vorlage, aus der Container gestartet werden; ein rasanter Neubau wirkt wie Magie. In Wahrheit ist es nur der Zwischenspeicher, der unveränderte Schichten wiederverwendet.
Wer sein erstes Dockerfile, die Schritt-für-Schritt-Bauanleitung für ein Image, schreibt, baut oft von Grund auf neu und staunt über die Wartezeit. Das kostet in jeder Continuous-Integration-Pipeline, die jede Codeänderung automatisch baut und testet, unnötig Zeit.
Ein Layer ist eine Schicht, ein Zwischenstand des Dateisystems, den Docker beim Bauen einzeln speichert. Jede Dockerfile-Anweisung wie RUN, COPY oder ADD erzeugt eine eigene Schicht; ein Dockerfile beschreibt Schritt für Schritt, wie das Image gebaut wird. Trifft der Zwischenspeicher auf eine bekannte Schicht, wird sie nicht neu gebaut, sondern direkt verwendet.
Weil jede Schicht auf dem Ergebnis der vorherigen aufbaut, gilt: Sobald eine Schicht geändert wurde, werden diese und alle folgenden Schichten neu gebaut. Beim COPY-Schritt entscheidet dabei allein der Inhalt der kopierten Dateien über den Treffer, nicht der Name des Schritts. Ein Dockerfile beginnt daher mit dem selten geänderten RUN-Schritt zum Installieren der Pakete, denn das ändert sich selten. Der eigene Quellcode mit COPY zu kopieren gehört ans Ende: Weil sich Code bei jedem Commit ändert, machen früh kopierte Dateien alle späteren Schichten ungültig. Der Zwischenspeicher nützt dann nichts.
Verwechselt wird der Layer mit dem fertigen Image, der unveränderlichen Vorlage für Container. Das Image besteht aus der gesamten Kette dieser Schichten; der Layer ist ein einzelner Baustein davon.
Der Bau ist nicht jedes Mal ein Neuanfang, sondern ein Abgleich von Schichten. Genau deshalb steht der Quellcode im Dockerfile ganz am Ende.
📌 Layer · COPY · Pipeline
📚 Cloud von Grund auf · Tag 5 von 30
#docker #iac #devops
2 Tage vor
Ein Deployment funktioniert wie ein Vorarbeiter, der eine Personalplanung im Kopf hat. Er weiß, wie viele Leute arbeiten sollen, und meldet sofort, wenn jemand fehlt.
Der Vorarbeiter hat einen Plan: Drei Arbeiter an einer Station. Kommt einer nicht, schickt er einen Ersatz. Der Ersatz übernimmt dieselbe Aufgabe, ohne dass jemand nachfragen muss. Der Vorarbeiter prüft dabei nicht die Stimmung oder die Leistung. Er zählt nur: Sind noch drei da? Solange die Zahl stimmt, greift er nicht ein.
In Kubernetes ist der Vorarbeiter das Deployment, eine Verwaltungseinheit für gleichartige Pods. Der Pod ist die kleinste betreibbare Einheit und umhüllt einen oder mehrere Container, also Anwendungen samt Abhängigkeiten. Der Plan steckt im Feld replicas: Dort steht die Soll-Stärke, etwa die Zahl drei. Fällt ein Pod aus, startet das Deployment automatisch einen neuen. Kubernetes verteilt die Pods dabei auf die Knoten, die Arbeitsrechner des Clusters.
Ein Deployment für eine Webanwendung mit replicas: 3 erzeugt drei gleiche Pods. Stürzt einer ab, läuft die Zahl ohne Eingriff auf drei zurück. Die Container eines Pods teilen sich eine IP-Adresse und reden über localhost miteinander.
Das Bild hat eine Grenze: Ein Arbeiter bleibt derselbe Mensch, ein ersetzter Pod ist eine neue Instanz mit neuer IP-Adresse. Der Vorarbeiter delegiert auch aktiv, das Deployment vergleicht nur Ist und Soll. Stabile Adressen für Anfragen liefert deshalb ein Kubernetes-Service.
Pods also nie von Hand starten: Wer replicas selbst überwacht, ersetzt keine ausgefallenen Pods. Deployment heißt nicht Pod, sondern Soll-Stärke, die Kubernetes von selbst hält.
📌 Pod · Deployment · replicas
📚 Cloud von Grund auf · Tag 4 von 30
#kubernetes #devops #docker
2 Tage vor
Die meisten Neulinge wundern sich, warum ein kleiner Code-Fix den kompletten Docker-Build neu auslöst. Dabei entscheidet oft nur die Reihenfolge der Zeilen im Dockerfile über Sekunden oder Minuten Bauzeit.
Das Symptom: Nach jeder noch so kleinen Codeänderung läuft der Bau minutenlang durch. Pakete werden erneut installiert, obwohl sich daran nichts geändert hat. Der Build-Cache, also das Zwischenspeichern bereits gebauter Schritte, greift scheinbar nie.
Dahinter steckt das Schichtprinzip: Jede Zeile im Dockerfile (der Bauanleitung für ein Image) erzeugt eine eigene Schicht. Das fertige Image, also die unveränderliche Vorlage für Container, besteht aus diesen Schichten wie ein Stapel. Eine unveränderte Schicht wird aus dem Cache wiederverwendet. Ändert sich eine Zeile, wird sie neu gebaut, und alle folgenden ebenso, weil sie auf dem Ergebnis aufbauen. Steht COPY, das Kopieren eigener Dateien, früh im Dockerfile, macht jede Codeänderung den Rest ungültig.
Konkret: Ein Dockerfile beginnt mit FROM, dann RUN zum Installieren der Abhängigkeiten, dann erst COPY des Quellcodes. Wer umgekehrt erst den Code kopiert und danach RUN ausführt, baut die Abhängigkeiten bei jedem Fix neu. Die Regel lautet: Anweisungen mit selten ändernden Inhalten wie RUN an den Anfang, Anweisungen mit häufig ändernden Inhalten wie COPY ans Ende.
So prüft man es: Beim Bau die Ausgabe der Zeilen ansehen, die als wiederverwendet markiert sind. Zeigen die frühen Zeilen wie die Abhängigkeiten einen Treffer und startet der Neubau erst beim Kopieren des Quellcodes, stimmt die Anordnung.
Schichten sind keine Zufallsprodukte, sondern ein Stapel: Ein früher Treffer im Cache spart alles darunter. Ordnung im Dockerfile heißt Reihenfolge nach Änderungshäufigkeit.
📌 Dockerfile-Schichten · Build-Cache · Reihenfolge nach Änderungshäufigkeit
📚 Cloud von Grund auf · Tag 4 von 30
#docker #kubernetes #devops
2 Tage vor
Die meisten Docker-Neulinge wundern sich, warum jeder Build Minuten dauert. Dabei entscheidet oft weniger die Größe des Projekts über die Bauzeit, sondern die Reihenfolge der Zeilen im Dockerfile.
Ein Dockerfile ist eine Textdatei mit Anweisungen wie FROM, COPY und RUN, aus denen docker build ein Image erzeugt – eine portable, gepackte Umgebung für eine Anwendung. Wer die Schichten versteht, baut deutlich schneller.
📦 Jede Dockerfile-Anweisung erzeugt ihre eigene Schicht.
Eine Schicht (Layer) ist das Dateisystem-Änderungsprotokoll genau einer Anweisung; das fertige Image entsteht als Stapel dieser Schichten übereinander. Die Anweisungen werden von oben nach unten abgearbeitet. Beispiel: erst FROM, dann COPY der Paketliste, dann RUN zur Installation der Abhängigkeiten, erst danach COPY des Quellcodes.
🔑 Der Build-Cache prüft jede Anweisung von oben nach unten.
Der Build-Cache ist ein Zwischenspeicher früherer Schichten; Docker vergleicht Anweisung und Eingaben mit der gecachten Version. Ist eine Schicht unverändert, wird sie samt aller darunterliegenden wiederverwendet. Ab der ersten geänderten Anweisung wird alles Folgende neu gebaut.
📈 Häufig Geändertes gehört ans Ende des Dockerfiles.
Klassischer Einsteigerirrtum: Quellcode früh per COPY übernehmen. Dann läuft bei jeder Codeänderung auch die teure Abhängigkeitsinstallation erneut, obwohl sich nichts daran geändert hat. Steht die COPY-Zeile für den Code dagegen ganz unten, bleibt der Cache für die Installation intakt.
Die Reihenfolge heißt nicht Geschmackssache, sondern Cache-Strategie: selten Geändertes zuerst, häufig Geändertes zuletzt – Basis-Image und Abhängigkeiten vor dem eigenen Quellcode.
📌 Schichten · Build-Cache · Anweisungsreihenfolge
📚 Cloud von Grund auf · Tag 4 von 30
#docker #devops #CloudHosting
2 Tage vor
Viele Dockerfiles beginnen damit, das gesamte Projekt per COPY zu kopieren. Dabei zerstört jede Quellcode-Änderung den gesamten Build-Cache.
Wer ein Dockerfile schreibt, begegnet sofort dem Build-Cache. Wer ihn nicht kennt, wartet bei jedem Neubau Minuten statt Sekunden.
Ein Dockerfile ist eine Liste von Anweisungen, die mit docker build zu einem Image (einer startfertigen Vorlage für Container) verarbeitet wird. Jede Anweisung erzeugt eine Schicht, also das Änderungsprotokoll dieser einen Zeile im Dateisystem. Das Image ist ein Stapel dieser Schichten; docker run startet daraus den Container.
Der Cache prüft beim Neubau jede Anweisung von oben nach unten. Ist eine Zeile unverändert, wird ihre Schicht samt aller darunterliegenden wiederverwendet. Ab der ersten geänderten Zeile wird alles Folgende neu gebaut, auch wenn es sich gar nicht verändert hat.
Konkret: Zuerst FROM, also die Wahl des Basis-Images als Startpunkt, dann COPY der Paketliste, dann RUN zur Installation der Abhängigkeiten, erst danach COPY des Quellcodes und der Startbefehl. Ändert sich nur der Quellcode, bleibt die teure Installation im Cache. Steht die Quellcode-Zeile dagegen oben, läuft RUN bei jeder kleinen Änderung erneut.
Verwechselt wird der Cache gern mit dem Build-Kontext, also dem Verzeichnis, das dem Build als Quelle dient. Der Kontext bestimmt, welche Dateien überhaupt an COPY übergeben werden; der Cache bestimmt, welche Schichten wiederverwendet werden. Eine .dockerignore-Datei hält Unnötiges wie .git aus dem Kontext fern und beschleunigt den Build zusätzlich.
Der Build-Cache belohnt nicht die schönste Zeile, sondern die stabilste Reihenfolge: Selten Geändertes nach oben, Häufig Geändertes nach unten.
📌 Layer · Build-Cache · Reihenfolge im Dockerfile
📚 Cloud von Grund auf · Tag 4 von 30
#docker #devops #CloudHosting
2 Tage vor
Die meisten Anfänger tippen los und wundern sich über langsame Builds. Dabei ist ein Dockerfile ein Rezept mit fester Anweisungsreihenfolge.
Ein Dockerfile beschreibt Schritt für Schritt, wie ein Container-Image entsteht. Das Image ist die unveränderliche Vorlage, aus der Container gestartet werden.
Zuerst steht die FROM-Anweisung: Sie legt ein Basis-Image fest, etwa eine schlanke Linux-Distribution mit Python. Jede Anweisung erzeugt dabei eine Schicht, und die Reihenfolge entscheidet über den Build-Cache. Selten geänderte Schritte wie Abhängigkeiten gehören deshalb vor häufig geänderten wie dem Quellcode.
Dann folgt COPY. Es kopiert Dateien aus dem Build-Kontext in das Image, also aus dem Verzeichnis, das dem Build mitgegeben wird. Ein häufiger Irrtum: Dateien außerhalb dieses Kontexts sind schlicht nicht verfügbar. Bewährt hat sich, zuerst nur die Datei mit den Abhängigkeiten zu kopieren und zu installieren, dann erst den Quellcode.
Danach kommen RUN für Installationsbefehle sowie USER. Ohne USER läuft der Prozess im Container als root, also mit vollen Rechten. Die Anweisung USER setzt einen unprivilegierten Benutzer und senkt das Risiko, falls der Container kompromittiert wird.
Zuletzt legen CMD den Startbefehl und EXPOSE den Port fest. EXPOSE dokumentiert nur, welchen Port die Anwendung im Container erreicht; geöffnet wird er erst beim Start mit docker run. Der Befehl docker build arbeitet das Dockerfile ab und erzeugt das Image, versehen mit einem Tag wie 1.2. Solche Tags sind beweglich; ein Digest wie sha256:… identifiziert dagegen genau einen Inhalt.
Ein Dockerfile ist also kein Skript, sondern ein Rezept: Jede Anweisung baut eine Schicht, und deren Reihenfolge bestimmt Tempo und Sicherheit des Images.
📌 Schichten und Build-Cache · COPY und Build-Kontext · USER statt root
📚 Cloud von Grund auf · Tag 3 von 30
#docker #devops #CloudSecurity
2 Tage vor
Viele reden von Containern, meinen aber das Image – und umgekehrt. Dabei ist der Unterschied so klar wie der zwischen Backrezept und Kuchen.
Die Verwechslung liegt an der Sprache: Docker nennt beides fast gleich, und die Begriffe treten immer paarweise auf. Ein Fehler im laufenden Container zeigt sich erst später als verlorene Arbeit.
Ein Image ist eine unveränderliche Vorlage: eine Datei-Sammlung, in der Anwendung, Laufzeit-Umgebung, Bibliotheken und Konfiguration fest eingefroren sind. Nach dem Bau wird es nicht mehr geändert, sondern nur durch ein neues ersetzt – das Prinzip heißt Immutable Infrastructure. Beschrieben wird der Bau in einem Dockerfile, einer Schritt-für-Schritt-Anleitung. Beispiel: Ein Image enthält Python in einer festen Version plus den eigenen Anwendungscode.
Ein Container ist die laufende Instanz, die aus genau diesem Image gestartet wird. Er verpackt die Anwendung mit ihren Abhängigkeiten und teilt sich den Kernel (den Kern) des Host-Betriebssystems, startet dadurch schneller als eine virtuelle Maschine. Aus ein und demselben Image lassen sich beliebig viele Container starten, die alle identisch beginnen. Beispiel: Drei Container aus demselben Python-Image laufen gleichzeitig auf drei Rechnern.
Das Image bleibt unverändert, der Container ist vergänglich. Jede Änderung am laufenden Container verliert mit dessen Löschung ihre Spur.
Faustregel: Änderungen gehören immer in ein neues Image, das man über das Dockerfile baut – niemals in den laufenden Container.
Ein Image ist die Vorlage, ein Container deren laufende Kopie. Wer am Container schraubt, arbeitet im Sandkasten; wer am Image baut, arbeitet für jeden künftigen Start.
📌 Image = Vorlage · Container = Instanz · Änderungen ins Dockerfile
📚 Cloud von Grund auf · Tag 3 von 30
#docker #devops #kubernetes
3 Tage vor
Ein Container ist ein Mieter im Mehrfamilienhaus: Das Fundament gehört allen, die Einrichtung ist privat. Eine virtuelle Maschine baut dagegen ein eigenes Haus mit eigenem Keller. Genauer: mit einem kompletten Betriebssystem.
Alle Mieter teilen sich dasselbe Gebäude, dieselbe Heizung und Wasserleitung. Jede Wohnung ist trotzdem abgeschlossen; der Nachbar sieht nichts hinein. Zieht ein Mieter aus, hinterlässt er nur seine Möbel, kein ganzes Haus.
Das gemeinsame Gebäude ist der Kernel, also der Kern des Betriebssystems, der Prozesse, Speicher und Hardwarezugriff verwaltet. Die abgeschlossene Wohnung ist der Prozessraum: Jeder Container sieht nur eigene Prozesse, eigenes Dateisystem und eigenes Netzwerk. Die privaten Möbel sind das Container-Image, die unveränderliche Vorlage mit Anwendung, Laufzeitbibliotheken und Konfigurationsdateien.
Ein Dockerfile beschreibt Schritt für Schritt, wie ein Image gebaut wird. Solch ein Image ist meist nur wenige Megabytes bis wenige hundert Megabytes groß, während ein VM-Abbild mit vollem Betriebssystem mehrere Gigabyte umfasst. Deshalb startet ein Container in Sekunden, während eine virtuelle Maschine erst ihr eigenes Betriebssystem bootet – bei AWS heißt dieser Dienst EC2.
Das Bild hat eine Grenze: Ein Mieter kann fast beliebig wirtschaften, ein Container braucht den passenden Kernel. Container setzen auf Linux auf und teilen sich dessen Kernel-Funktionen. Ein Linux-Container läuft deshalb nicht direkt auf einem Windows-Host ohne Linux-Kernel.
Container sind also keine „leichteren VMs“: Eine VM kapselt Hardware, ein Container kapselt nur die Anwendung.
📌 Kernel · Container-Image · Prozessraum
📚 Cloud von Grund auf · Tag 3 von 30
#docker #CloudHosting #Linux

3 Monate vor
💡 Warum WebAssembly (Wasm) die Zukunft der Softwareentwicklung verändert
JavaScript hat das Web aufgebaut, aber WebAssembly (Wasm) definiert gerade seine Grenzen neu.
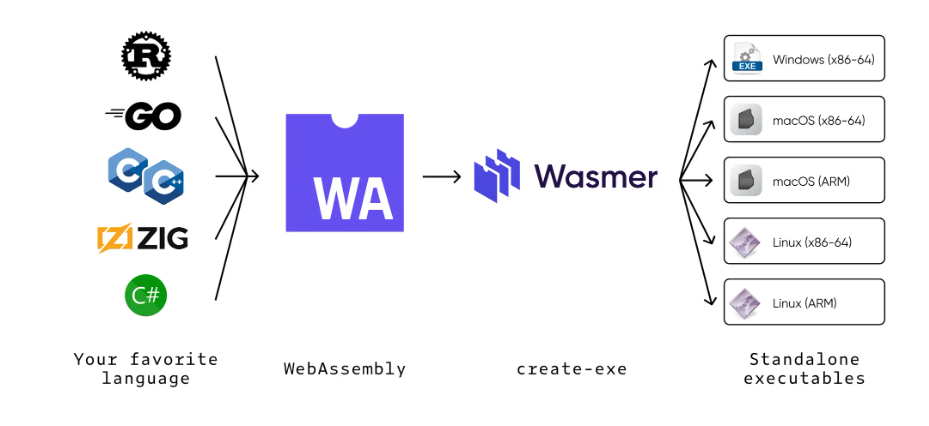
🚀Wasm ist kein Ersatz für JavaScript, sondern der Turbo an seiner Seite. Es handelt sich um ein binäres Codeformat, das Code aus performanten Sprachen wie Rust, C++ oder Go mit nahezu nativer Geschwindigkeit direkt im Browser ausführt.
Warum ist das ein Game-Changer?
Brachiale Performance: Perfekt für rechenintensive Aufgaben wie Bildbearbeitung (z. B. Figma, Photoshop Web), 3D-Gaming und KI-Modelle direkt auf dem Client.Maximale Sicherheit: Der Code läuft isoliert in einer sicheren Sandbox im Browser.
Nicht mehr nur im Web: Dank WASI (WebAssembly System Interface) erobert Wasm gerade den Server- und Cloud-Bereich als blitzschnelle, leichtgewichtige Alternative zu Docker-Containern.
Die Ära, in der komplexe Software zwingend installiert werden musste, ist vorbei. Das Web ist die universelle Plattform – angetrieben von WebAssembly.
#WebAssembly #WASM #WebDevelopment #SoftwareEngineering #TechTrends #cloudnative

10 Monate vor
CI/CD Pipeline von 25 Minuten auf 3 Minuten optimiert. Die drei größten Hebel:
1. Parallele Test-Stages statt sequentiell (12min gespart)
2. Docker Layer Caching für Build-Steps (5min gespart)
3. Nur geänderte Module testen (affected-Analyse mit nx)
Das Ergebnis: Entwickler deployen jetzt 8x am Tag statt 2x. Kleinere Releases, weniger Risiko, schnelleres Feedback. Die Pipeline selbst ist jetzt der Enabler statt der Bottleneck. #cicd #effizienz #devops

1 Jahr vor
In den letzten Jahren galt die Cloud als das Nonplusultra für moderne IT-Infrastrukturen. Flexibel, skalierbar, überall verfügbar – so das Versprechen der großen Anbieter wie Amazon Web Services (AWS), Microsoft Azure oder Google Cloud. Doch ein wachsender Trend zeigt: Immer mehr Unternehmen kehren der Cloud den Rücken und setzen wieder auf Self-Hosting. Warum?
1. Volle Kontrolle statt Abhängigkeit
Wer seine IT auslagert, gibt auch ein Stück Kontrolle ab. Viele Unternehmen erkennen inzwischen, wie stark sie von Drittanbietern abhängig sind – sei es beim Zugriff auf ihre Daten, bei Preismodellen oder beim Thema Verfügbarkeit. Beim Self-Hosting liegt alles in der eigenen Hand: Die Infrastruktur, die Datenhoheit und die Anpassungsmöglichkeiten.
2. Datenschutz – ein starkes Argument
Die Cloud wirft datenschutzrechtlich viele Fragen auf. Besonders in Europa sorgt der Wunsch nach DSGVO-Konformität für Unsicherheit. Self-Hosting bietet hier klare Vorteile: Alle Daten bleiben auf lokalen Servern, Zugriffsrechte sind transparent geregelt, und sensible Informationen müssen nicht über globale Rechenzentren verteilt werden.
3. Kalkulierbare Kosten
Cloud-Dienste wirken anfangs günstig – doch mit wachsender Nutzung steigen auch die laufenden Kosten. Traffic, Speicherplatz und Zusatzfunktionen summieren sich schnell. Self-Hosting ist meist mit einer einmaligen Investition verbunden. Danach sind die laufenden Betriebskosten planbar und unabhängig von Drittanbieter-Preismodellen.
4. Maßgeschneiderte IT-Strukturen
Nicht jedes Unternehmen passt in die Standardlösungen der Cloud. Mit Self-Hosting lassen sich Systeme und Dienste individuell konfigurieren – genau so, wie es die internen Prozesse erfordern. Ob Intranet, Dateisynchronisation, Kommunikation oder Backup: Die eigene Serverinfrastruktur bietet maximale Flexibilität.
5. Technologische Reife
Moderne Open-Source-Lösungen wie Proxmox, Nextcloud, Docker oder KVM machen Self-Hosting heute einfacher und sicherer denn je. Die IT-Abteilungen können auf stabile, gut dokumentierte Tools setzen, die skalierbar und wartbar sind.
---
Fazit
Self-Hosting ist mehr als ein Trend – es ist eine strategische Entscheidung für mehr Unabhängigkeit, Sicherheit und Nachhaltigkeit. Für Unternehmen, die ihre digitale Souveränität stärken möchten, ist jetzt der richtige Zeitpunkt, die Cloud zu hinterfragen und eigene Wege zu gehen.

Abonnieren zum Entsperren
Für 10€ / Monatlich


